Una sitemap è un file XML che elenca gli URL di un sito web e trasmette questo elenco ai motori di ricerca. Google lo legge per scoprire le pagine, ma non si impegna né a scansionarle tutte né a indicizzarle. Comprendere la distinzione tra scoperta, scansione e indicizzazione cambia il modo di utilizzare una sitemap: non è uno strumento per l’invio automatico, ma uno strumento diagnostico.
Cosa considera davvero Google nella sitemap XML
La sitemap invia a Google un elenco di URL accompagnato da metadati. Non tutti questi metadati hanno lo stesso peso. Google ignora i campi priority e changefreq: compilarli non modifica in alcun modo il comportamento del crawler.
Il campo lastmod, invece, può influenzare la frequenza con cui una pagina viene scansionata di nuovo. A una condizione: che la data sia affidabile e corrisponda a una modifica effettiva dei contenuti. Una sitemap in cui il valore lastmod viene aggiornato ogni giorno senza che i contenuti cambino perde ogni credibilità agli occhi di Google, che finisce per ignorare questo segnale.
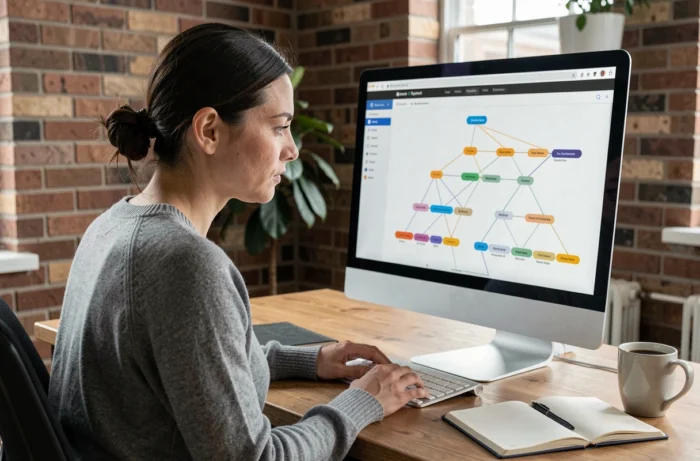
Una sitemap inviata tramite Search Console genera un rapporto specifico. Questo rapporto indica il numero di URL scoperti, ma non quanti sono stati scansionati né quanti sono stati indicizzati. Esplorare il sito iLinks in Google Search permette di visualizzare rapidamente la struttura di una sitemap e individuare le differenze tra ciò che viene dichiarato e ciò che Google elabora effettivamente.
Sitemap e indicizzazione: individuare le differenze in Search Console
Il valore principale di una sitemap non sta nella sua creazione, ma in ciò che rivela quando la si confronta con i dati di Search Console. Un sito può dichiarare diverse centinaia di URL nella propria sitemap e vederne indicizzata solo una parte.
Tre livelli di elaborazione da distinguere
Un URL presente nella sitemap attraversa tre fasi successive, ognuna delle quali può non andare a buon fine indipendentemente dalle altre:
- Scoperta: Google ha letto l’URL nella sitemap. Il rapporto Sitemap conferma questa fase, ma non garantisce altro.
- Scansione: Googlebot ha effettivamente scaricato la pagina. Un URL può rimanere nello stato “Scoperta, non ancora indicizzata” per settimane se il budget di scansione del sito è limitato.
- Indicizzazione: la pagina è stata analizzata, ritenuta sufficientemente pertinente e aggiunta all’indice. Le pagine scansionate possono essere escluse per contenuti duplicati o di scarso valore, oppure per segnali canonical contraddittori.
Per individuare il punto in cui si verifica il blocco, confrontate il numero di URL nella sitemap con il rapporto “Pagine” (in precedenza Copertura) di Search Console. Le pagine bloccate nella fase “Scoperta” indicano un problema di budget di scansione. Quelle bloccate nella fase “Scansionata, ma non indicizzata” indicano un problema di qualità o di segnali tecnici.
URL canonico dichiarato e URL canonico scelto da Google
Una verifica spesso trascurata consiste nel controllare se l’URL canonico scelto da Google corrisponde a quello dichiarato nella sitemap. Lo strumento Controllo URL di Search Console mostra questa informazione per ogni pagina.
Una discrepanza tra i due indica un conflitto tra i segnali. Per esempio, la sitemap può elencare un URL in HTTPS mentre i link interni puntano ancora alla versione HTTP. Oppure un tag rel=”canonical” nel codice sorgente può rimandare a una pagina diversa da quella dichiarata nella sitemap.
Queste contraddizioni non comportano penalizzazioni, ma diluiscono i segnali della pagina. Google sceglie quindi l’URL canonico che ritiene più coerente, e può finire per indicizzare una pagina diversa da quella desiderata. Verificare un campione di pagine strategiche tramite il Controllo URL resta il metodo più affidabile per individuare questo tipo di problema.
Struttura della sitemap: indice, segmentazione e file multipli
Una sitemap può essere un singolo file oppure un indice di sitemap che rimanda a più file secondari. I siti di grandi dimensioni utilizzano questa segmentazione per organizzare gli URL in base al tipo di contenuto: pagine prodotto, articoli del blog, categorie, pagine in lingue diverse.
Criteri utili per la segmentazione
Segmentare una sitemap per tipo di contenuto permette di individuare rapidamente quale gruppo di pagine presenta problemi. Se le pagine prodotto sono indicizzate correttamente, ma gli articoli no, la sitemap segmentata rende immediata la diagnosi in Search Console.
Una buona segmentazione segue una logica funzionale, non tecnica. Separare gli URL in base alle directory del server non serve a nulla se queste non corrispondono a tipi di contenuto distinti. Al contrario, una sitemap per categoria di contenuto facilita il monitoraggio pagina per pagina.
Ogni file sitemap è soggetto a un limite di dimensione. Google accetta i file che non superano tale limite e sono codificati in UTF-8. Un file troppo grande o codificato in modo errato verrà semplicemente ignorato, in alcuni casi senza alcun messaggio di errore esplicito.
Leggere la sitemap di un concorrente per analizzarne la struttura
La sitemap di un sito di terze parti è spesso accessibile pubblicamente. Il primo passo consiste nel controllare il file robots.txt, generalmente disponibile all’indirizzo /robots.txt, che indica la posizione della sitemap tramite una direttiva Sitemap.
Se il file robots.txt non contiene indicazioni, provare i percorsi più comuni (/sitemap.xml, /sitemap_index.xml) permette di trovare la sitemap nella maggior parte dei casi. I CMS come WordPress, Shopify o Wix generano automaticamente una sitemap in una posizione standard.
L’analisi della sitemap di un concorrente rivela diverse informazioni strutturali: il numero di pagine pubblicate, la distribuzione tra i tipi di contenuto e la frequenza di pubblicazione (tramite le date lastmod, se indicate). Questi dati permettono di valutare le dimensioni di un sito senza accedere ai suoi strumenti di amministrazione.
La sitemap resta un file dichiarativo. Mostra ciò che il proprietario del sito desidera rendere visibile ai motori di ricerca, non necessariamente tutte le pagine esistenti. Le pagine escluse dalla sitemap a volte sono rivelatrici quanto quelle che vi compaiono.